Imaginez une bibliothèque où chaque livre est ouvert simultanément, même si vous ne lisez qu'une seule page. C'est le problème fondamental des modèles denses traditionnels : pour générer un mot, ils activent tous leurs paramètres, gaspillant une énergie folle et ralentissant tout. En 2024, les chercheurs ont atteint un mur. Les coûts de calcul explosaient, mais les gains de performance plafonnaient. La solution ? Ne plus tout activer à la fois. Bienvenue dans l'ère du routage sparse et dynamique, une approche qui change radicalement la façon dont nous concevons l'intelligence artificielle.
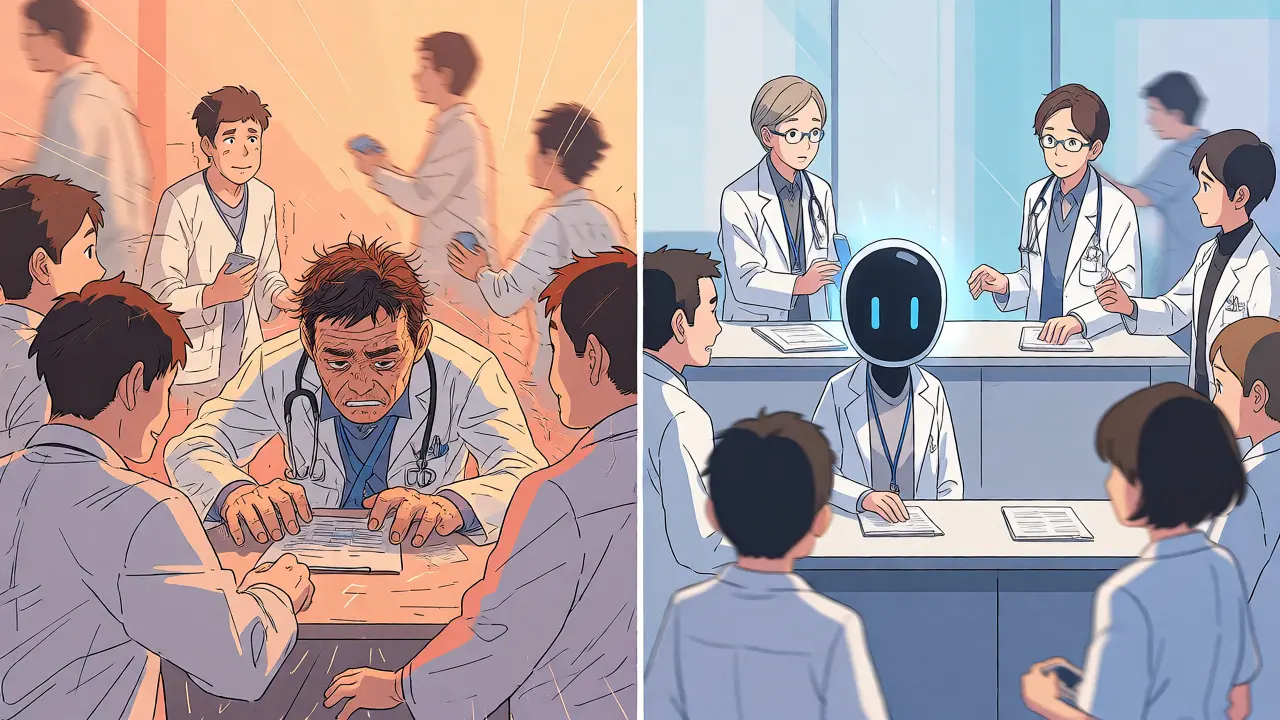
Ce n'est pas juste une optimisation mineure. C'est un changement de paradigme. Au lieu d'utiliser un réseau neuronal unique et massif qui traite chaque entrée de la même manière, les architectures modernes utilisent un système de "Mixture of Experts" (MoE). Pensez-y comme à un hôpital spécialisé. Dans un modèle dense, un seul généraliste tente de traiter toutes les maladies possibles, ce qui est inefficace. Dans un modèle MoE, un agent d'accueil (le routeur) examine votre symptôme et vous dirige vers le cardiologue ou le neurologue spécifique. Vous n'avez pas besoin que le dentiste vous examine pour une douleur au genou. Cette analogie illustre parfaitement le concept de sparse activation.
Pourquoi le Routage Dense a Atteint ses Limites
Jusqu'à récemment, la règle était simple : plus grand est mieux. GPT-3 et ses successeurs ont prouvé que l'augmentation du nombre de paramètres améliorait les capacités du modèle. Mais cette stratégie a un prix exorbitant. Le coût de calcul augmentait de manière quadratique par rapport au nombre de paramètres. Pour entraîner un modèle de plusieurs centaines de milliards de paramètres, il fallait des fermes de serveurs entières et des mois de temps machine. Et pire encore, lors de l'inférence (l'utilisation quotidienne du modèle), chaque token généré nécessitait de passer par l'intégralité du réseau, même si seules quelques parties étaient réellement pertinentes pour la phrase en cours.
Les contraintes économiques et environnementales sont devenues critiques. Les factures d'électricité devenaient insoutenables pour les entreprises tech, et l'empreinte carbone inquiétait les régulateurs. Il fallait trouver un moyen de maintenir la capacité représentationnelle massive sans payer le prix fort à chaque étape de calcul. C'est là que le routage dynamique entre en jeu. Il permet de découpler la taille totale du modèle de son coût opérationnel.
Le Fonctionnement Technique des Mixture of Experts (MoE)
Concrètement, comment ça marche ? Un architecture MoE remplace certaines couches, généralement les réseaux feed-forward, par plusieurs sous-réseaux appelés "experts". Si vous avez 128 experts, le modèle possède potentiellement 128 fois plus de paramètres qu'un modèle standard de même profondeur. Mais ici réside la magie : pour chaque token d'entrée, un petit réseau séparé appelé "gating network" ou "routeur" décide quels experts doivent être activés.
La plupart du temps, seuls 1 ou 2 experts sur les 128 disponibles sont sélectionnés. Cela signifie que bien que le modèle total puisse dépasser 100 milliards de paramètres, le coût de calcul par token reste comparable à celui d'un modèle dense beaucoup plus petit. Par exemple, si vous activez 2 experts sur 64, vous n'utilisez que 3% de la puissance de calcul brute disponible, tout en accédant à la connaissance encodée dans l'ensemble des 64 experts. C'est une efficacité redoutable.
Le processus suit une logique précise :
- Analyse de l'entrée : Le token est converti en vecteur d'activation.
- Décision du routeur : Le gating network calcule une probabilité pour chaque expert.
- Sélection top-k : On garde les k meilleurs candidats (souvent k=1 ou k=2).
- Traitement parallèle : Seuls ces experts traitent le token.
- Agrégation : Les sorties sont combinées pondérativement pour produire la réponse finale.
Cette méthode transforme la complexité algorithmique. Là où le calcul dense croissait quadratiquement avec la taille, le calcul MoE croît approximativement linéairement. Cela ouvre la voie à des modèles de plusieurs billions de paramètres qui restent déployables sur du matériel standard.
RouteSAE : Une Innovation pour l'Interprétabilité
Le routage ne s'applique pas seulement aux experts au sein d'une couche. Des recherches récentes, notamment présentées lors des conférences EMNLP 2025, ont introduit des concepts comme RouteSAE (Route Sparse Autoencoder). Cette variante innovante utilise un routeur léger pour gérer les flux résiduels multi-couches. Au lieu de figer le chemin de l'information à travers les couches statiques du transformer, RouteSAE attribue dynamiquement des poids aux activations provenant de différentes profondeurs du réseau.
Pourquoi est-ce important ? Parce que cela améliore l'interprétabilité. Les approches classiques peinent souvent à expliquer pourquoi un modèle prend une décision spécifique. RouteSAE, en revanche, maintient des scores d'interprétation élevés (supérieurs à 4.4 selon les études récentes) quel que soit le niveau de sparsité imposé. Il crée un profil de poids en forme de U, indiquant que les couches peu profondes (features bas-niveau) et les couches profondes (features haut-niveau) contribuent toutes deux de manière équilibrée. C'est une avancée majeure pour comprendre la "boîte noire" des grands modèles.
Défis Techniques : Équilibre de Charge et Stabilité
Tout n'est pas rose dans le monde du routage dynamique. Le principal défi technique est l'équilibre de charge. Imaginez un restaurant où tous les clients demandent la spécialité du chef, laissant les autres cuisiniers inactifs. Dans un modèle MoE, si le routeur favorise trop certains experts, ceux-ci deviennent des goulots d'étranglement, tandis que d'autres restent inutilisés. Ce phénomène, appelé "expert collapse", dégrade les performances et annule les gains d'efficacité.
Pour contrer cela, les ingénieurs intègrent des fonctions de perte auxiliaires pendant l'entraînement. Ces pénalités forcent le routeur à répartir équitablement les tokens entre les experts. NVIDIA, dans sa documentation développeur de 2025, souligne l'importance cruciale de ces mécanismes pour éviter que certains experts ne meurent littéralement faute d'utilisation. De plus, la gestion de la mémoire devient complexe. Même si seuls quelques experts sont actifs, tous les paramètres doivent rester chargés en mémoire vive (VRAM). Cela exige une bande passante mémoire très élevée, car les accès mémoire deviennent aléatoires plutôt que séquentiels.
| Critère | Modèle Dense Standard | Modèle MoE (Sparse) |
|---|---|---|
| Coût de calcul par token | Élevé (proportionnel à la taille totale) | Faible (proportionnel aux experts actifs) |
| Consommation mémoire | Optimale (accès séquentiel) | Élevée (stockage complet + accès aléatoire) |
| Complexité d'implémentation | Faible | Élevée (nécessite infrastructure spécialisée) |
| Scalabilité | Limitée par le coût quadratique | Excellente (croissance linéaire) |
| Stabilité d'entraînement | Très stable | Peut souffrir d'instabilités de routage |
L'Impact sur l'Industrie et l'Avenir
Les géants de la tech ont déjà adopté cette approche. Google avec Switch Transformer, Meta avec la série Llama, et Mistral AI ont intégré des composants MoE dans leurs produits phares. Pourquoi cet engouement ? Parce que l'efficacité énergétique est devenue un argument commercial majeur. Les modèles MoE réduisent la consommation d'énergie à l'inférence de 30 à 50% par rapport à leurs équivalents denses. Pour une entreprise qui sert des millions d'utilisateurs, cela représente des économies colossales.
Cameron R. Wolfe, chercheur reconnu, affirme que "la capacité représentationnelle supplémentaire de ces modèles sparses fait une énorme différence dans le domaine de la modélisation du langage". Il ne s'agit plus seulement de faire moins cher, mais de faire mieux. En ayant accès à plus de connaissances paramétriques sans payer le prix du calcul complet, les modèles MoE surpassent souvent les modèles denses de taille similaire sur des tâches complexes de raisonnement.
Cependant, le chemin vers la production reste semé d'embûches. Les praticiens rapportent qu'il faut souvent 3 à 6 mois d'efforts dédiés pour maîtriser l'implémentation de ces architectures, contre quelques semaines pour un modèle dense classique. La courbe d'apprentissage est raide, nécessitant une expertise à la fois en réseaux neuronaux traditionnels et en systèmes distribués.
Conclusion Pratique : Faut-il Passer au MoE ?
Si vous développez une application IA à grande échelle, la question n'est plus de savoir si vous utiliserez le routage dynamique, mais quand. Pour les prototypes rapides ou les petits modèles, la simplicité du dense reste attractive. Mais dès que vous visez des performances état de l'art ou que vos coûts d'inférence deviennent problématiques, le MoE est inévitable. Comme le déclare Cerebras, pour atteindre des modèles de billion de paramètres entraînables et déployables, la sparsité via MoE devient "la seule approche viable".
L'avenir appartient probablement aux architectures hybrides, combinant différents types de sparsité et des politiques de routage apprises automatiquement. Nous ne sommes qu'au début de cette révolution silencieuse qui rendra l'IA non seulement plus intelligente, mais aussi durable.
Qu'est-ce qu'un Mixture of Experts (MoE) exactement ?
Un Mixture of Experts est une architecture neuronale qui divise un grand modèle en plusieurs sous-réseaux appelés "experts". Au lieu d'activer tous les paramètres pour chaque entrée, un mécanisme de routage dynamique sélectionne seulement quelques experts pertinents (par exemple, 2 sur 64) pour traiter chaque token. Cela permet d'avoir un modèle très grand (avec beaucoup de connaissances) tout en gardant un coût de calcul faible par requête.
Pourquoi le routage dynamique est-il plus efficace que les modèles denses ?
Les modèles denses activent tous leurs neurones pour chaque prédiction, ce qui coûte cher en calcul et en énergie. Le routage dynamique permet de n'activer qu'une fraction des paramètres (souvent moins de 25%) selon la nature de l'entrée. Cela réduit drastiquement le temps d'inférence et la consommation électrique, tout en permettant au modèle d'accéder à une base de connaissances plus vaste grâce à la multiplication des experts.
Quels sont les principaux défis techniques des modèles MoE ?
Les deux défis majeurs sont l'équilibre de charge et la gestion de la mémoire. L'équilibre de charge consiste à s'assurer que tous les experts sont utilisés de manière égale pour éviter que certains ne soient surchargés tandis que d'autres restent inactifs. La gestion de la mémoire est difficile car tous les paramètres des experts doivent rester chargés en VRAM, même s'ils ne sont pas utilisés à chaque instant, ce qui demande une bande passante mémoire élevée.
Comment fonctionne le "gating network" dans un modèle MoE ?
Le gating network est un petit réseau neuronal léger qui analyse l'entrée actuelle et calcule une probabilité pour chaque expert disponible. Il choisit ensuite les "k" meilleurs experts (top-k) en fonction de ces scores. Les sorties de ces experts sélectionnés sont ensuite combinées, souvent via une moyenne pondérée basée sur les scores de confiance attribués par le routeur.
Qu'est-ce que RouteSAE et en quoi est-il différent ?
RouteSAE (Route Sparse Autoencoder) est une variante récente qui applique le concept de routage dynamique non seulement aux experts d'une couche, mais aussi aux flux d'activations entre différentes couches du modèle. Il utilise un routeur pour décider quelles couches contribueront le plus à la représentation actuelle, améliorant ainsi l'interprétabilité et la flexibilité de l'architecture par rapport aux méthodes statiques.
Est-ce que les modèles MoE consomment plus de mémoire que les modèles denses ?
Oui, c'est un compromis important. Bien que le coût de calcul (FLOPs) soit inférieur, la consommation mémoire est supérieure car tous les paramètres de tous les experts doivent être stockés en mémoire pour être accessibles rapidement. Cela nécessite du matériel avec une grande capacité de VRAM et une haute bande passante, contrairement aux modèles denses où l'on peut parfois utiliser des techniques de compression plus simples.