Imaginez demander à une intelligence artificielle de lire un graphique financier complexe, d'analyser une radiographie médicale ou de comprendre le contexte émotionnel d'une vidéo sans aucune instruction préalable. Ce n'est plus de la science-fiction, c'est la réalité des LLMs multimodaux, des systèmes capables de fusionner la compréhension visuelle et linguistique dans une seule architecture neuronale. Contrairement aux modèles classiques qui traitaient les mots comme des symboles isolés, ces nouvelles générations "voient" le monde tel que nous le percevons : un mélange fluide d'images, de textes, d'audio et de vidéos.
Si vous êtes développeur, chercheur ou simplement curieux des capacités actuelles de l'IA, comprendre comment ces modèles opèrent est crucial. Ils ne se contentent pas de superposer deux technologies ; ils créent un espace commun où un pixel et un mot peuvent interagir directement. Voici comment cette magie technique fonctionne réellement sous le capot, et pourquoi elle change tout pour nos flux de travail.
Qu'est-ce qu'un LLM multimodal exactement ?
Pour faire simple, un Large Language Model (LLM) multimodal est un réseau de neurones profond entraîné sur des données hétérogènes. Il ne traite pas seulement du texte, mais intègre nativement d'autres types de données sensorielles. Là où un modèle traditionnel comme BERT était limité au texte, un modèle comme GPT-4V ou Gemini accepte des images en entrée et produit du texte en sortie, ou inversement. L'objectif n'est pas juste de décrire une image, mais de raisonner sur son contenu en lien avec une question textuelle.
Cette capacité repose sur une idée fondamentale : transformer tout type de donnée en vecteurs numériques comparables. Une image n'est plus une matrice de pixels brute, mais une séquence de "tokens visuels" qui partagent le même espace sémantique que les tokens textuels. Cela permet au modèle de dire "ce carré rouge dans l'image correspond au concept de 'danger' dans ma phrase", créant ainsi un pont cognitif entre la perception et le langage.
L'architecture Transformer : Le cœur du réacteur
Tout repose sur l'architecture Transformer, introduite en 2017. Initialement conçue pour la traduction automatique, elle a été adaptée pour gérer plusieurs modalités simultanément. La clé de voûte est le mécanisme d'auto-attention. Dans un modèle standard, l'attention calcule les relations entre les mots d'une phrase. Dans un modèle multimodal, cette attention s'étend aux patches d'images.
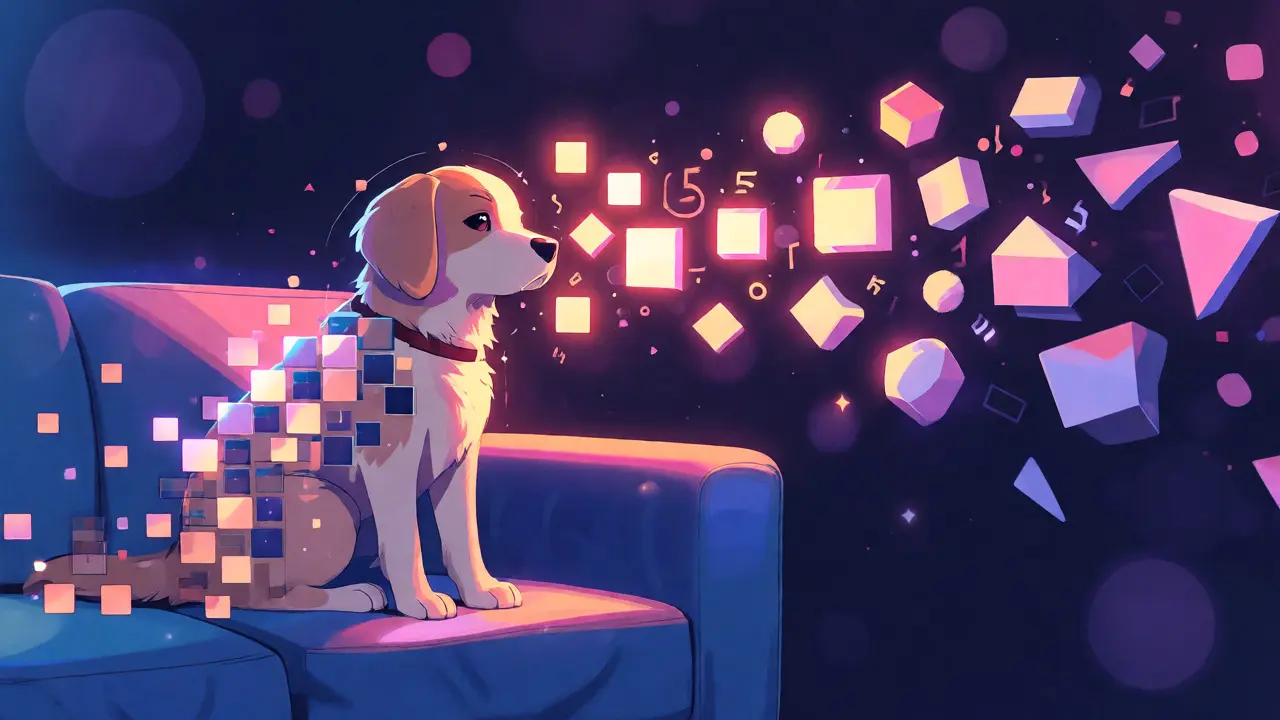
Concrètement, lorsqu'on soumet une photo à un modèle comme Claude 3, celle-ci est découpée en petits carrés de 28x28 pixels, appelés patches. Chaque patch devient un token visuel. Ces tokens sont ensuite concaténés avec les tokens textuels de votre prompt. Le modèle utilise alors ses couches de self-attention pour décider si le mot "chien" doit prêter plus d'attention à certains patches de l'image plutôt qu'à d'autres. C'est ce processus qui permet une compréhension fine, comme identifier non seulement qu'il y a un chien, mais aussi qu'il est assis sur un canapé bleu.
| Approche | Description Technique | Exemples Notables | Avantages |
|---|---|---|---|
| Hétérogène (Dual Encoder) | Encoders séparés pour la vision et le texte, reliés par une couche de projection. | LLaVA, CLIP | Efficace, utilise des pré-entraînements existants solides. |
| Unifiée (Native Multimodal) | Un seul transformateur traite tous les tokens (texte, image, audio) ensemble. | Gemini, Flamingo | Raisonnement plus profond, meilleure intégration contextuelle. |
| Fusion Bottleneck | Échange d'informations limité à certaines couches spécifiques pour économiser la mémoire. | MBT (Multimodal Bottleneck Transformer) | Scalable pour les vidéos longues et hautes résolutions. |
De l'image au token : La transformation visuelle
Comment une image devient-elle compréhensible pour un modèle de langage ? La première étape est souvent réalisée par un encodeur visuel, généralement un Vision Transformer (ViT). Cet encodeur divise l'image en patches, les aplati, et projette chaque patch dans un espace vectoriel de haute dimension via une convolution ou une couche linéaire.
Une fois cette représentation visuelle obtenue, il faut l'aligner avec l'espace du langage. Deux méthodes dominent aujourd'hui. La première, utilisée par des modèles open-source comme LLaVA, consiste à utiliser un simple connecteur MLP (Multi-Layer Perceptron) pour mapper les caractéristiques visuelles vers l'espace caché du LLM. C'est rapide et efficace, car on peut entraîner uniquement le connecteur tout en gelant les poids du grand modèle de langue.
La seconde méthode, adoptée par des géants comme Google avec Gemini, est plus radicale. Ici, le modèle est entraîné dès le départ pour traiter les images et le texte comme des langues équivalentes. Il n'y a pas de "traduction" explicite entre les deux ; ils vivent dans le même espace latent. Cette approche native permet des tâches complexes, comme répondre à une question sur une vidéo de 1 heure, car le modèle comprend la temporalité et la cohérence sémantique globale sans perte d'information lors de la conversion.
Les défis techniques : Coût, Contexte et Hallucinations
Malgré leurs prouesses, ces modèles ont des limites physiques et économiques bien réelles. Le principal goulot d'étranglement reste la fenêtre de contexte. Les images consomment énormément de tokens. Par exemple, une image haute résolution peut coûter jusqu'à 1 500 tokens à un modèle comme GPT-4V, tandis que Claude 3 facture environ 1 600 tokens pour une image de taille moyenne. Si vous envoyez un PDF de 50 pages avec des graphiques, vous pouvez rapidement saturer la mémoire vive du modèle.
Un autre problème persistant est l'hallucination visuelle. Le modèle peut "inventer" des détails présents dans l'image parce qu'ils sont statistiquement probables dans le texte, mais absents visuellement. Par exemple, si vous demandez "Combien de personnes portent des lunettes ?", le modèle pourrait deviner "3" basé sur des tendances générales, même si l'image montre clairement 2 personnes. Les benchmarks comme MMBench ou SEED-Bench tentent de quantifier ces erreurs, montrant que même les meilleurs modèles font encore des erreurs sur les tâches de comptage fin ou de localisation spatiale précise.
Cas d'usage concrets : Au-delà de la légende d'image
Où ces modèles brillent-ils vraiment ? Pas seulement dans la description d'images drôles. Leur vraie valeur ajoutée réside dans le raisonnement multi-modal.
- Analyse de documents : Extraire des données structurées d'un reçu froissé ou d'un tableau Excel scanné. Le modèle comprend la mise en page (visuel) et le contenu (texte).
- Développement logiciel : Convertir une maquette Figma ou une capture d'écran d'une interface utilisateur directement en code HTML/CSS fonctionnel.
- Assistance médicale : Bien que non diagnostique, aider les médecins à rédiger des rapports en décrivant des scanners ou des radios, en croisant les observations visuelles avec les notes cliniques.
- Robotique et conduite autonome : Comprendre des instructions naturelles comme "Tourne à gauche après le panneau stop rouge" en corrélant la scène visuelle en temps réel avec la commande textuelle.
Prenez le cas de GPT-4o, conçu comme un modèle "omni". Il ne se contente pas de voir et de lire ; il peut écouter et parler. Cette intégration complète réduit la latence, permettant des interactions fluides où l'IA répond instantanément à une question posée oralement en regardant une vidéo partagée en direct.
L'avenir : Vers une intelligence générale incarnée ?
Le marché de l'IA multimodale explose, avec des projections estimant sa croissance annuelle à plus de 30% d'ici 2030. Mais la technologie évolue plus vite que les chiffres. Nous assistons à une transition des modèles statiques (traitement d'une image unique) vers des agents dynamiques capables de maintenir un contexte sur des heures de vidéo ou des milliers de lignes de code.
Les prochaines étapes concernent probablement une meilleure gestion de la mémoire à long terme et une réduction des biais visuels. Aujourd'hui, un modèle peut mal interpréter une image culturelle spécifique faute de données d'entraînement diversifiées. À mesure que les architectures deviennent plus efficaces, nous verrons émerger des modèles plus petits, exécutables localement sur des smartphones, capables de fournir une assistance visuelle intelligente sans dépendre du cloud.
Quelle est la différence principale entre un VLM et un LLM multimodal ?
Techniquement, les termes sont souvent interchangeables, mais un VLM (Vision-Language Model) se concentre spécifiquement sur l'interaction image-texte. Un LLM multimodal est un terme plus large qui inclut potentiellement l'audio, la vidéo et d'autres capteurs, utilisant une architecture de base similaire à celle d'un grand modèle de langage pur.
Pourquoi les images coûtent-elles si cher en tokens ?
Parce qu'une image est convertie en centaines ou milliers de tokens visuels pour être comprise par le modèle. Contrairement à un mot qui est un token unique, une image haute résolution nécessite beaucoup de données numériques pour capturer les détails fins, augmentant ainsi le calcul nécessaire et le coût API.
Les modèles multimodaux peuvent-ils remplacer les OCR traditionnels ?
Dans la plupart des cas, oui. Les modèles comme GPT-4V ou Gemini offrent une extraction de texte supérieure car ils comprennent le contexte et la mise en page, là où les OCR classiques échouent souvent sur les tableaux complexes ou les écritures manuscrites mal formées.
Quel est le meilleur modèle open-source pour débuter avec la vision ?
LLaVA (Large Language and Vision Assistant) est très populaire car il combine un encodeur visuel CLIP avec un modèle Vicuna léger. Il est facile à installer, bien documenté et offre de bonnes performances pour des projets personnels ou de recherche académique.
Comment réduire les hallucinations visuelles ?
Utilisez des prompts précis demandant de citer les zones de l'image, fournissez des images de haute qualité sans flou, et demandez toujours au modèle de justifier sa réponse. Évitez les questions ouvertes trop vagues sur des détails fins.