Vous avez déjà remarqué à quel point nous sommes bavards avec les intelligences artificielles ? Nous leur confions nos e-mails, nos diagnostics médicaux et même nos secrets de famille sans y penser. Pourtant, une étude récente publiée sur OpenReview en novembre 2024 révèle un chiffre alarmant : les utilisateurs partagent entre 69,7 % et 94,3 % plus d'informations personnelles que nécessaire pour obtenir une réponse utile. C'est comme si vous donniez la clé de votre maison à un voisin juste pour lui demander l'heure. Cette sur-divulgation expose non seulement vos données à des risques de fuite, mais elle nourrit aussi des modèles qui peuvent reconstituer votre profil complet à partir de miettes.
La minimisation des données dans la conception de prompts pour les grands modèles de langage (LLM) est la réponse technique à ce problème. Il ne s'agit pas simplement de supprimer des mots, mais de trouver le point d'équilibre exact où la perte d'information reste nulle ou minime pour la qualité de la réponse, tout en réduisant drastiquement l'exposition à la vie privée. Des chercheurs de Carnegie Mellon et Stanford ont formalisé cette approche en octobre 2024, démontrant qu'il est possible de quantifier la divulgation la moins révélatrice tout en maintenant l'utilité du service. Voici comment appliquer ces stratégies concrètement pour protéger vos données sans sacrifier la performance de votre IA.
Pourquoi la minimisation est devenue critique pour les LLM
Avant 2022, la confidentialité des données était surtout une question de stockage sécurisé. Avec l'essor des applications grand public basées sur les LLM, le risque s'est déplacé vers le flux de données en temps réel. Chaque prompt envoyé est potentiellement mémorisé par le modèle ou utilisé pour affiner les algorithmes de personnalisation. Si vous envoyez un texte contenant votre nom, votre ville et votre profession, le modèle peut inférer bien plus que ce que vous avez explicitement dit.
Le cadre défini par l'étude conjointe Carnegie Mellon-Stanford définit la minimisation comme « la quantification de la divulgation la moins révélante pour la vie privée qui maintient l'utilité ». En termes simples, il faut savoir exactement ce dont le modèle a besoin pour répondre correctement, et rien de plus. Les conséquences de l'ignorance de ce principe sont tangibles : vulnérabilités à la mémorisation (le modèle recrache vos données plus tard), suivi via la personnalisation contextuelle, et risques juridiques majeurs sous le RGPD, notamment l'article 5(1)(c) qui impose de limiter la collecte aux seules finalités nécessaires.
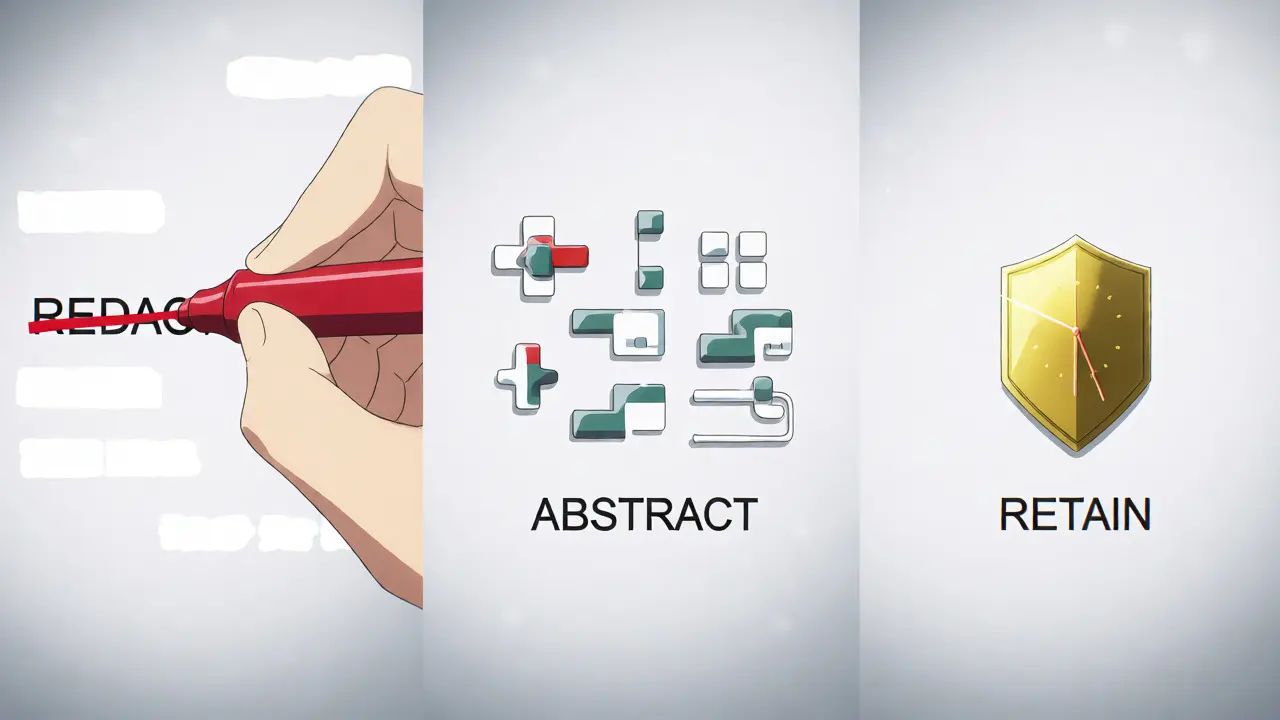
Les trois piliers techniques : REDACT, ABSTRACT, RETAIN
Pour mettre en œuvre la minimisation, les ingénieurs utilisent trois transformations principales appliquées au prompt avant son envoi au modèle. Comprendre la différence entre ces méthodes est crucial pour choisir la bonne stratégie selon votre cas d'usage.
- REDACT (Suppression) : Cette méthode consiste à effacer complètement les informations sensibles identifiées. Par exemple, remplacer « Jean Dupont, ingénieur à Lyon » par « [NOM], [POSTE] à [VILLE] ». C'est la méthode la plus sûre pour la confidentialité, mais elle peut parfois rendre la réponse trop générique si le contexte manque.
- ABSTRACT (Abstraction) : Ici, on remplace les détails spécifiques par des termes généraux. Au lieu de dire « j'ai mal au dos depuis 3 jours après avoir soulevé 50 kg », on dira « douleur dorsale aiguë post-effort ». Le modèle comprend la gravité et le type de problème sans connaître les chiffres exacts ni l'historique précis.
- RETAIN (Conservation) : On garde l'information intacte car elle est jugée indispensable à la résolution de la tâche. C'est souvent le cas pour les dates précises dans un contrat ou les valeurs numériques dans un calcul financier.
La difficulté ne réside pas dans la définition de ces catégories, mais dans leur application automatique. Un algorithme doit décider, mot par mot, quelle transformation appliquer. L'approche de recherche en file de priorité (priority-queue tree search) développée par les universitaires permet de naviguer dans cet espace de transformation pour trouver le point optimal. Contrairement à une suppression naïve qui détruit le sens, cette méthode préserve l'utilité de la réponse tout en maximisant la réduction des données.
L'influence cruciale de la taille du modèle
Un fait contre-intuitif ressort des recherches actuelles : plus le modèle est gros, mieux il tolère la minimisation des données. Cela semble paradoxal, mais les modèles de pointe comme GPT-4 possèdent une complexité architecturale telle qu'ils peuvent inférer le contexte manquant à partir de très peu d'indices. Ils « devinent » intelligemment ce qui a été supprimé grâce à leurs connaissances générales vastes.
| Type de modèle | Taux de succès REDACT | Taux de succès ABSTRACT | Taux de RETAIN (non-minimisé) |
|---|---|---|---|
| Modèles de pointe (ex: GPT-4) | 85,7 % | 8,6 % | 5,7 % |
| Petits modèles open-source (< 3B paramètres) | 19,3 % | 11,0 % | 69,7 % |
Ces chiffres issus de l'étude d'octobre 2024 montrent que les petits modèles locaux, souvent utilisés pour la confidentialité on-premise, souffrent davantage de la suppression d'informations. Si vous utilisez un modèle léger comme qwen2.5-0.5b, vous devrez conserver beaucoup plus de données brutes pour obtenir une réponse correcte, ce qui annule en partie le bénéfice de la minimisation. Pour les entreprises, cela signifie qu'il existe un compromis économique : utiliser un modèle puissant coûte cher en API mais permet une anonymisation plus agressive, tandis qu'un modèle local nécessite de partager plus de détails personnels.
Méthodes alternatives et leurs limites
Si la transformation directe du prompt est efficace, d'autres approches existent, chacune avec ses propres avantages et inconvénients. Il est important de ne pas voir la minimisation comme une solution unique, mais comme une couche parmi d'autres dans une architecture de sécurité globale.
La confidentialité différentielle, qui ajoute du bruit statistique aux données, offre une protection théorique forte mais échoue souvent à maintenir l'utilité pratique des réponses textuelles, avec une efficacité de minimisation plafonnant autour de 42,8 %. À l'inverse, l'apprentissage fédéré permet de traiter les données localement, atteignant 63,5 % d'efficacité, mais exige une refonte complète de l'infrastructure informatique.
Une autre piste prometteuse est la génération augmentée par récupération (RAG). En externalisant la mémoire factuelle dans une base de données vectorielle sécurisée, on réduit la quantité de données personnelles envoyées dans le prompt principal. Les systèmes RAG démontrent une efficacité de minimisation de 72,4 %, bien qu'ils nécessitent une maintenance continue de la base de données. Enfin, le fine-tuning par adaptation de rang faible (LoRA) permet d'adapter des modèles spécifiques à des tâches minimisées avec un coût computationnel réduit, offrant 68,9 % d'efficacité.
Guide pratique pour une mise en œuvre réussie
Implémenter ces stratégies ne se fait pas du jour au lendemain. Les équipes de sécurité mettent en moyenne 8 à 12 semaines pour maîtriser ces techniques, selon les benchmarks de Cognativ. Voici les étapes clés pour démarrer sans perturber vos workflows existants.
- Pré-scan des prompts : Avant d'envoyer quoi que ce soit au LLM, utilisez des outils de gestion de la posture de sécurité des données (DSPM) pour identifier les éléments sensibles (PII). Des solutions comme Proofpoint peuvent réduire l'exposition aux données sensibles de 83,7 % grâce à ce pré-scan.
- Application des transformations : Appliquez automatiquement les règles REDACT ou ABSTRACT basées sur l'espace de priorisation de la vie privée. Ne laissez pas l'utilisateur décider manuellement ; l'automatisation est la seule façon de garantir la cohérence.
- Validation de l'utilité : Vérifiez systématiquement que la réponse générée répond toujours au besoin initial. Fixez un seuil de préservation de l'utilité, par exemple 85 %, comme recommandé par les recherches de Carnegie Mellon. Si la qualité chute en dessous, ajustez dynamiquement le niveau de minimisation.
Attention aux faux positifs. Une étude de Privacy Pointers note un taux de 18,3 % de fausses alertes dans la détection automatisée des PII. Cela signifie que des informations anodines peuvent être masquées inutilement, dégradant la réponse. Il est essentiel de créer des listes blanches personnalisées pour votre secteur d'activité.
Le rôle des régulations et l'avenir de la conformité
La pression réglementaire accélère l'adoption de ces pratiques. Le Comité européen de la protection des données (CEPD) a publié des lignes directrices en avril 2025 exigeant des « pratiques de minimisation démontrables » pour toute application LLM traitant des données de citoyens européens. Les actions coercitives liées aux pratiques de données des LLM ont augmenté de 214 % en 2024 par rapport à 2023.
Les secteurs régulés sont en tête. Dans la santé, 58,7 % des entreprises ont adopté des protocoles formels, souvent pour passer des audits HIPAA ou GDPR complexes. Un témoignage récent d'une entreprise de santé technologique indique que l'implémentation d'une double barrière (pré-scan du prompt et caviardage de la sortie) a permis de réussir 100 % des audits, contre 62 % auparavant. Gartner prédit que 70 % des grandes entreprises auront mis en place des protocoles formels de minimisation des données LLM d'ici 2026.
En fin de compte, la minimisation des données n'est pas seulement une contrainte technique, c'est un avantage concurrentiel. Elle réduit la surface d'attaque, diminue les coûts de stockage des logs et renforce la confiance des utilisateurs. Les modèles eux-mêmes sont de mauvais prédicteurs de la minimisation idéale, montrant un biais constant vers l'abstraction excessive. C'est donc à l'ingénieur humain, assisté par des oracles de minimisation dynamiques, de calibrer ce délicat équilibre entre intelligence et intimité.
Quel est le principal risque si je n'applique pas la minimisation des données ?
Le risque principal est la violation involontaire de la vie privée et les sanctions légales associées. Les études montrent que les utilisateurs partagent près de 90 % de données superflues, ce qui expose non seulement les informations directement fournies, mais permet aussi au modèle de reconstruire des profils détaillés via la corrélation de données, augmentant le risque de fuites et de non-conformité au RGPD.
La minimisation des données dégrade-t-elle toujours la qualité de la réponse ?
Non, si elle est bien implémentée. Les modèles de grande taille (comme GPT-4) sont robustes et peuvent inférer le contexte manquant, permettant une réduction des données jusqu'à 85 % avec une perte de précision négligeable. Cependant, les petits modèles (moins de 3 milliards de paramètres) souffrent davantage de la suppression d'informations et nécessitent une approche plus prudente.
Quelle est la différence entre REDACT et ABSTRACT ?
REDACT supprime entièrement l'information sensible (par exemple, remplacer un nom par [NOM]), tandis qu'ABSTRACT la remplace par un terme général ou une catégorie (par exemple, remplacer "diabète de type 2" par "maladie chronique"). REDACT est plus sûr pour la confidentialité stricte, tandis qu'ABSTRACT conserve plus de contexte sémantique pour le modèle.
Les outils DSPM sont-ils nécessaires pour la minimisation ?
Bien que non strictement obligatoires, ils sont fortement recommandés pour les environnements professionnels. Les outils de Data Security Posture Management (DSPM) permettent d'identifier automatiquement les données sensibles dans les prompts avant leur envoi. Selon les experts, leur utilisation combinée avec le pré-scan peut réduire l'exposition aux données sensibles de plus de 80 %.
Comment gérer la latence induite par la minimisation ?
La minimisation ajoute environ 320 à 450 ms de traitement par requête. Pour les applications critiques en temps réel, il est conseillé d'utiliser des modèles plus légers pour l'étape de minimisation elle-même, ou de mettre en cache les résultats des transformations pour les requêtes répétitives. L'optimisation des infrastructures vectorielles (pour le RAG) aide également à compenser ce délai.