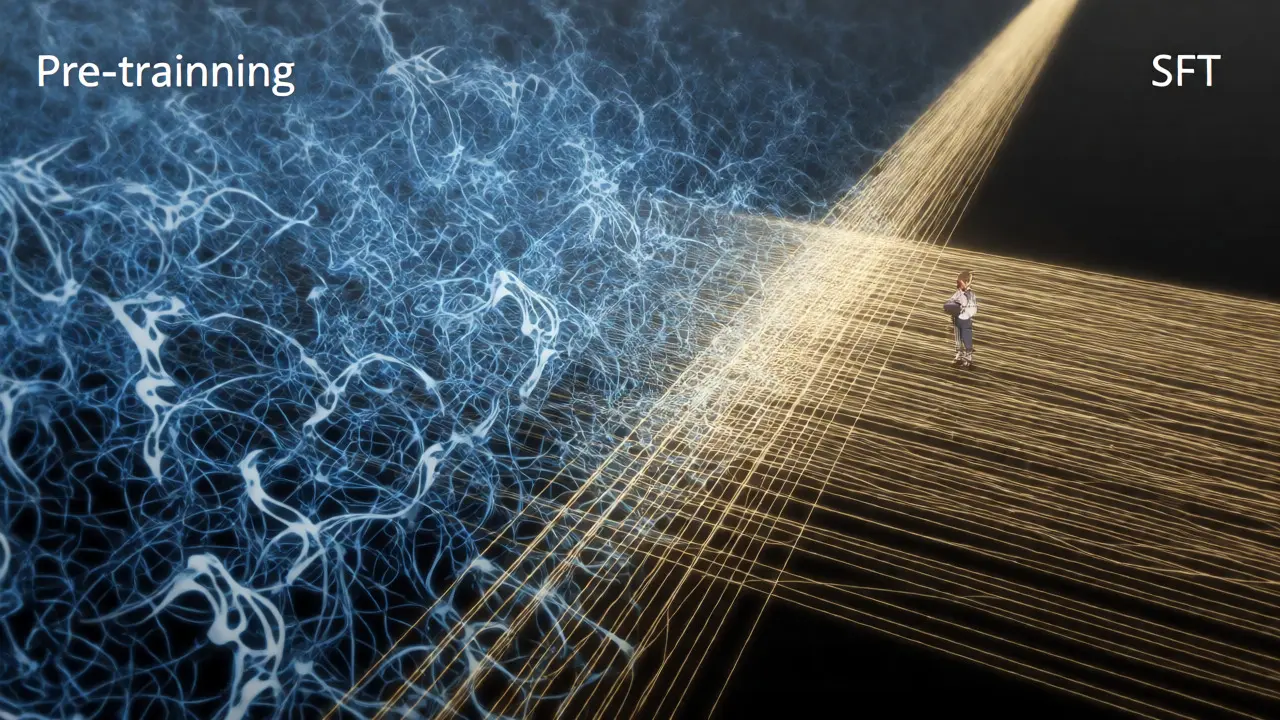
Vous avez probablement entendu parler de la magie des grands modèles de langage (LLM), mais vous vous demandez comment passer d'un modèle générique qui hallucine à un assistant spécialisé qui comprend votre jargon métier. La réponse ne se trouve pas dans le pré-entraînement massif, mais dans une étape cruciale appelée Supervised Fine-Tuning ou SFT. C'est l'art d'enseigner à un modèle pré-entraîné non seulement ce qu'il sait, mais comment le dire.
Imaginez que le pré-entraînement soit comme envoyer un étudiant à l'université pendant quatre ans pour absorber tout le savoir humain. Le SFT, c'est le stage obligatoire où cet étudiant apprend à appliquer ses connaissances dans un contexte spécifique, avec les bonnes manières et le bon format. Sans cette étape, votre modèle est brillant mais indiscipliné. Avec, il devient un outil fiable.
Pourquoi le SFT est-il indispensable ?
Le Supervised Fine-Tuning est la deuxième phase du pipeline standard d'entraînement des LLM, située entre le pré-entraînement et l'apprentissage par renforcement (RLHF). Son objectif principal est simple : transformer un modèle "base" en un assistant capable de suivre des instructions. Selon les recherches de Google sur InstructGPT, cette technique permet d'aligner le comportement du modèle sur les préférences humaines avec une efficacité redoutable.
Ce qui rend le SFT si attractif pour les praticiens, c'est son rapport coût/performance. Là où le pré-entraînement nécessite des milliers de GPU et des mois de calcul, le SFT peut être réalisé avec seulement 0,1 % à 1 % de ces ressources. Pour une entreprise, cela signifie qu'il est économiquement viable de personnaliser un état de l'art sans ruiner le budget informatique. Mais attention, cette économie a un prix : la qualité des données. Si vos exemples sont médiocres, votre modèle le sera aussi.
La préparation des données : 70 % du travail
Ne vous laissez pas tromper par la simplicité apparente du code Python. Dans la vraie vie, la préparation des données consomme souvent 60 à 70 % du temps total du projet. Pourquoi ? Parce que le SFT repose entièrement sur des paires entrée-sortie de haute qualité. Il ne s'agit pas simplement de collecter des textes, mais de créer des dialogues synthétiques ou réels où chaque réponse est irréprochable.
Combien de données faut-il ? Les experts divergent, mais voici une règle empirique solide : commencez avec 500 à 1 000 exemples de très haute qualité pour valider votre approche. Pour des tâches complexes, visez entre 10 000 et 50 000 exemples. Une étude de Stanford CRFM a montré que la qualité prime largement sur la quantité : 1 500 exemples curés par des experts ont surpassé 50 000 exemples crowdsourcés de 22 % sur les tests FLAN. C'est contre-intuitif, mais crucial à retenir.
- Formatage strict : Utilisez des templates de prompts cohérents. Un changement mineur dans la formulation de l'instruction peut réduire la précision du modèle de 18 %.
- Séparation des jeux : Divisez toujours vos données en entraînement (70-80 %), validation (10-15 %) et test (10-15 %). Ne mélangez jamais les données de test avec l'entraînement, sinon vos métriques seront faussées.
- Cohérence du tokenizer : Assurez-vous que le padding side est réglé sur "left" pour les modèles decoder-only afin d'éviter des problèmes d'attention silencieux.
L'implémentation technique avec LoRA et Hugging Face
Aujourd'hui, personne n'ajuste tous les paramètres d'un modèle de 7 milliards de poids. C'est trop coûteux en mémoire. La norme industrielle est devenue le Low-Rank Adaptation (LoRA), une méthode de PEFT (Parameter-Efficient Fine-Tuning) qui ne modifie qu'une fraction infime des paramètres (0,1 à 1 %).
Pour implémenter cela, la bibliothèque TRL (Transformer Reinforcement Learning) de Hugging Face est devenue l'outil de référence grâce à sa classe SFTTrainer. Voici le workflow typique d'un ingénieur ML en 2026 :
- Sélection du modèle : Choisissez un base model léger comme LLaMA-3 8B quantifié en 4-bit (nécessitant ~12 Go de VRAM) ou utilisez une API cloud comme Vertex AI.
- Configuration LoRA : Définissez le rang (
r=16our=32) et les modules cibles (généralement les couches d'attention Q, K, V, O). - Hyperparamètres critiques : Utilisez un taux d'apprentissage faible, entre
2e-5et5e-5. Un taux trop élevé provoque l'oubli catastrophique, où le modèle oublie ses connaissances générales. - Entraînement : Lancez l'entraînement pour 1 à 3 epochs seulement. Plus longtemps risque de surapprendre le bruit des données plutôt que la signal.
| Méthode | Ressources Mémoire (7B Model) | Complexité d'implémentation | Performance relative |
|---|---|---|---|
| Full Fine-Tuning | ~14 GB+ | Moyenne | 100 % (Référence) |
| LoRA (PEFT) | ~0.5 - 6 GB | Faible (via TRL) | 95-98 % |
| Prompt Engineering | Nulle (inférence seule) | Très faible | 60-75 % |
Les pièges courants et comment les éviter
Même avec les meilleurs outils, le diable se cache dans les détails. Le problème le plus fréquemment signalé sur les forums Hugging Face est l'oubli catastrophique. Cela arrive quand le modèle devient excellent sur votre tâche spécifique mais perd la capacité de tenir une conversation générale ou de répondre correctement à des questions factuelles simples. La solution ? Mélangez vos données spécifiques avec un petit échantillon de données générales lors de l'entraînement, ou réduisez drastiquement le learning rate.
Un autre piège classique est l'incohérence des templates. Si vous entraînez le modèle avec des formats d'instructions variés (parfois "Question: ...", parfois "Q: ..."), le modèle devient confus. Cameron Wolfe, ingénieur chez Hugging Face, souligne que cette incohérence peut nécessiter 30 % de données supplémentaires pour être compensée. Fixez un template unique et tenez-vous-y religieusement.
Enfin, ne négligez pas l'évaluation. La perplexité seule ne suffit pas pour des tâches conversationnelles. Vous devez mettre en place une évaluation humaine ou semi-automatisée vérifiant la pertinence, la sécurité et la cohérence. Une étude de Meta AI a montré que le SFT augmentait la précision de 25 à 40 % sur des tâches de domaine par rapport au prompt engineering seul, mais uniquement si la boucle de feedback était rigoureuse.
Quand choisir le SFT par rapport aux alternatives ?
Le SFT n'est pas une baguette magique universelle. Il excelle dans les tâches où il existe une "bonne réponse" claire, comme la génération de code, la classification de sentiments ou la traduction. GitHub Copilot, par exemple, utilise des techniques similaires pour atteindre un taux d'acceptation de 55,9 %.
Cependant, si votre objectif est d'optimiser des nuances subjectives comme la "politesse" ou l'"humour", le SFT atteint vite ses limites. C'est là que l'apprentissage par renforcement (RLHF) prend le relais. OpenAI a démontré avec InstructGPT que combiner SFT et RLHF atteignait 85 % de préférence humaine, contre 68 % avec le SFT seul. Donc, considérez le SFT comme la fondation nécessaire, mais pas suffisante, pour des assistants de niveau production hautement alignés.
Pour les entreprises, la tendance actuelle est à l'automatisation de la curation des données. Des plateformes comme Scale AI ou les nouveaux outils de Vertex AI utilisent désormais l'IA pour filtrer les exemples de mauvaise qualité, réduisant le temps de préparation manuel de 65 %. Si vous débutez, ne cherchez pas à perfectionner vos données indéfiniment. Commencez petit, validez, puis scalez.
Foire Aux Questions (FAQ)
Quelle est la différence principale entre le pré-entraînement et le Supervised Fine-Tuning ?
Le pré-entraînement expose le modèle à des téraoctets de texte brut pour lui apprendre la structure de la langue et les faits généraux, sans supervision explicite. Le SFT, en revanche, utilise des paires entrée-sortie étiquetées (comme "Question -> Réponse") pour enseigner au modèle comment suivre des instructions spécifiques et adopter un format de sortie désiré. Le SFT est beaucoup moins coûteux en calcul que le pré-entraînement.
Ai-je besoin de supercalculateurs pour faire du SFT ?
Non. Grâce aux techniques de PEFT comme LoRA et à la quantification (4-bit), vous pouvez affiner un modèle de 7 à 13 milliards de paramètres sur une seule carte graphique grand public avec 12-24 Go de VRAM (comme une RTX 3090 ou 4090). Pour des modèles plus petits ou des approches cloud, même une simple instance AWS ou GCP suffit.
Combien de données me faut-il pour commencer ?
Il n'y a pas de nombre magique, mais 500 à 1 000 exemples de très haute qualité constituent un point de départ viable pour tester une hypothèse. Pour des résultats robustes en production, visez entre 10 000 et 50 000 exemples. Rappelez-vous que la qualité de l'étiquetage est bien plus importante que le volume brut.
Qu'est-ce que l'oubli catastrophique et comment l'éviter ?
L'oubli catastrophique survient lorsque le modèle, en apprenant une nouvelle tâche spécifique, perd ses capacités générales acquises lors du pré-entraînement. Pour l'éviter, utilisez un taux d'apprentissage faible (ex: 2e-5), limitez le nombre d'epochs (1-3), et incluez éventuellement un mélange de données générales dans votre jeu d'entraînement SFT.
Le SFT remplace-t-il le Prompt Engineering ?
Pas complètement. Le Prompt Engineering est gratuit et rapide à tester, idéal pour le prototypage. Le SFT offre une meilleure performance, une latence réduite (car les instructions sont encodées dans les poids) et une cohérence supérieure. Souvent, on utilise le Prompt Engineering pour définir la stratégie, puis le SFT pour la verrouiller et optimiser les coûts d'inférence à grande échelle.