Apprentissage auto-supervisé en NLP : le socle des grands modèles de langage

Apprentissage auto-supervisé en NLP : le socle des grands modèles de langage

Renee Serda sept.. 9 5

Vous vous demandez comment une intelligence artificielle peut écrire un poème ou résumer un rapport sans qu'un humain ait passé des années à lui montrer quoi est « bon » ? La réponse ne se trouve pas dans des millions d'exemples annotés par des experts. Elle réside dans une astuce algorithmique brillante appelée apprentissage auto-supervisé (SSL). Cette technique permet aux modèles d'apprendre directement à partir de la structure brute du texte, transformant chaque phrase en sa propre source de vérité.

Sans cette approche, nous n'aurions jamais eu les grands modèles de langage (LLM) comme ChatGPT ou Llama qui font trembler l'industrie aujourd'hui. Imaginez essayer d'enseigner la grammaire française en ayant besoin d'une étiquette humaine pour chaque virgule placée correctement. Ce serait impossible. L'apprentissage auto-supervisé contourne ce goulot d'étranglement en générant ses propres étiquettes à partir des données non marquées. C'est le moteur silencieux qui alimente la révolution actuelle du traitement du langage naturel (NLP).

Pourquoi l'étiquetage manuel est devenu obsolète

Pendant des décennies, l'apprentissage supervisé était roi. Pour entraîner un modèle à reconnaître un spam, il fallait que des humains lisent des milliers d'e-mails et disent « spam » ou « pas spam ». Le problème ? Les données sont rares, chères et lentes à produire. De plus, un modèle entraîné uniquement sur des e-mails de spam ne comprendra rien à la poésie ou au code informatique.

L'apprentissage auto-supervisé change la donne en exploitant la nature même du langage. Contrairement aux images où le contenu est statique, le texte contient une information redondante et structurée. Si je cache le mot « soleil » dans la phrase « Il fait beau et le brille », le contexte fournit déjà la réponse. Le modèle n'a pas besoin d'un humain pour lui dire que la réponse est « soleil » ; il peut le deviner grâce aux mots environnants. En créant ces tâches de prédiction automatiques, on transforme un problème non supervisé en un problème supervisé massif, disponible gratuitement sur Internet.

Comment fonctionne la magie sous le capot

Le cœur de l'entraînement des LLM repose sur deux stratégies principales qui exploitent cette redondance. La première, utilisée par des modèles comme BERT, s'appelle le masquage de mots (Masked Language Modeling). Ici, le modèle reçoit une phrase avec certains mots cachés et doit les reconstruire. Il apprend ainsi le contexte bidirectionnel : ce qui vient avant ET après le mot manquant.

La seconde stratégie, celle qui a propulsé la génération de texte moderne, est la prédiction du prochain jeton (Next Token Prediction). C'est le mécanisme utilisé par GPT. Le modèle lit une séquence de texte et essaie de deviner le mot suivant. À chaque étape, la « bonne réponse » est simplement le mot qui suivait réellement dans le texte original. Comme le dit Snorkel AI, il existe toujours une réponse correcte spécifique : c'est le mot qui a été écrit. Le modèle classe toutes les possibilités possibles, attribuant une probabilité élevée au vrai mot et une faible aux autres. Répété des billions de fois, ce processus force le réseau de neurones à internaliser la syntaxe, la sémantique et même la logique du monde réel contenue dans le texte.

Comparaison des paradigmes d'apprentissage en NLP
Critère Apprentissage Supervisé Apprentissage Auto-Supervisé Apprentissage Non Supervisé
Source des étiquettes Annotation humaine coûteuse Générées automatiquement depuis les données Aucune étiquette explicite
Volume de données Limité (milliers/millions) Massif (milliards de tokens) Illimité mais peu structuré
Objectif principal Classification précise Compréhension contextuelle profonde Regroupement ou réduction de dimension
Exemple type Détecteur de sentiment basique Pré-entraînement de BERT/GPT Analyse thématique initiale
Illustration animée du masquage de mots avec une prédiction révélée par la lumière.

Les trois phases de construction d'un LLM

Il est crucial de comprendre que l'apprentissage auto-supervisé n'est que la première étape. Un modèle brut, aussi intelligent soit-il dans la prédiction de mots, ne sait pas nécessairement suivre une instruction complexe. La formation moderne suit donc un pipeline en trois temps bien établi.

  1. Pré-entraînement auto-supervisé : Le modèle avale des téraoctets de texte (livres, articles web, code). Il apprend la langue, les faits généraux et les structures logiques. À ce stade, il est excellent pour compléter des phrases, mais peut être imprévisible ou factuellement erratique.
  2. Réglage supervisé (Instruction Tuning) : Ici, on utilise quelques dizaines de milliers d'exemples annotés par des humains. On montre au modèle des paires question-réponse idéales. Il apprend à passer de « prédicteur de mots » à « assistant utile ».
  3. Apprentissage par renforcement avec feedback humain (RLHF) : Des évaluateurs humains comparent les réponses du modèle. Un modèle de récompense est entraîné pour favoriser les réponses jugées sûres, concises et pertinentes. Cette phase affine le ton et réduit les hallucinations.

Sans la phase 1, la phase 2 échouerait. Vous ne pouvez pas enseigner à un modèle à suivre des instructions s'il ne comprend pas d'abord ce que sont les mots et leur relation. L'auto-supervision crée la base de connaissances massive sur laquelle les phases suivantes ajoutent la nuance comportementale.

Transfert de connaissances et polyvalence

L'un des plus grands avantages de cette méthode est la capacité de transfert. Une fois qu'un modèle comme Llama 3 ou Mistral est pré-entraîné via SSL, il possède une compréhension générale du langage. Vous n'avez plus besoin de tout réapprendre si vous voulez créer un chatbot juridique ou un traducteur médical.

Vous prenez ce modèle généraliste et vous effectuez un réglage fin (fine-tuning) sur un petit ensemble de données spécifique. Par exemple, si vous avez seulement 500 contrats juridiques annotés, vous pouvez adapter le modèle pré-entraîné pour qu'il excelle dans l'analyse de clauses contractuelles. Sans l'auto-supervision préalable, ces 500 exemples seraient insuffisants pour entraîner un réseau de neurones profond à partir de zéro. C'est la raison pour laquelle les petites équipes peuvent désormais construire des outils puissants : elles héritent de l'intelligence acquise par les géants technologiques lors de leurs énormes sessions de pré-entraînement.
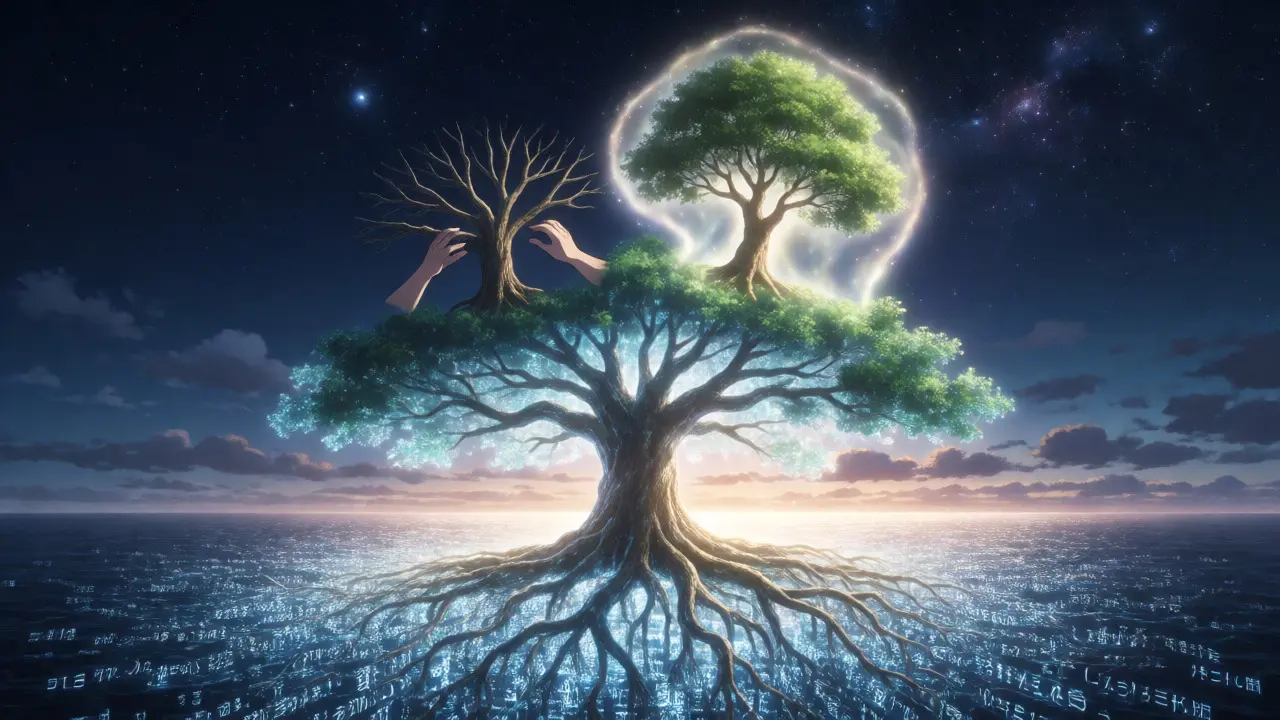
Arbre numérique symbolisant les trois phases d'entraînement d'un grand modèle de langage.

Limites et défis persistants

Malgré son succès, l'approche n'est pas parfaite. Le modèle apprend exactement ce qu'il voit. Si les données d'entraînement contiennent des biais historiques, des fausses informations ou des opinions dominantes, le modèle les reproduira fidèlement. L'auto-supervision est neutre : elle reflète la moyenne statistique du corpus, pas la vérité objective.

De plus, un modèle purement auto-supervisé n'est pas utilisable tel quel pour des tâches critiques. Il peut inventer des faits avec une grande confiance car son objectif est la vraisemblance linguistique, pas l'exactitude factuelle. C'est pourquoi les phases de supervision et de renforcement restent indispensables pour guider le modèle vers la fiabilité. Les chercheurs travaillent également sur des méthodes pour réduire la consommation énergétique de ces pré-entraînements massifs, qui nécessitent souvent des semaines de calcul sur des milliers de GPU.

Foire Aux Questions

Quelle est la différence entre apprentissage auto-supervisé et non supervisé ?

La distinction principale réside dans l'existence d'une cible. Dans l'apprentissage non supervisé (comme le clustering), il n'y a pas de bonne réponse définie ; le modèle cherche des structures intrinsèques. Dans l'apprentissage auto-supervisé, une tâche de prédiction crée une cible claire dérivée des données elles-mêmes (par exemple, prédire un mot masqué). Cela permet d'utiliser des techniques de rétropropagation classiques et de mesurer précisément la performance pendant l'entraînement.

Pourquoi les LLM ont-ils besoin de tant de données pour l'apprentissage auto-supervisé ?

Les réseaux de neurones transformer possèdent des milliards de paramètres. Pour ajuster tous ces poids efficacement sans sur-apprentissage (overfitting), ils ont besoin d'une variété immense de contextes linguistiques. Plus les données sont vastes et diverses, plus le modèle devient robuste, capable de gérer des idiomes, des termes techniques et des structures grammaticales complexes qu'il n'avait jamais vus auparavant.

L'apprentissage auto-supervisé est-il limité au texte ?

Non, bien que ce soit très efficace en NLP, cette méthode est largement utilisée en vision par ordinateur (prédire les pixels manquants d'une image) et en audio (compléter des segments de voix). Le principe reste le même : utiliser la structure interne des données multimodales pour générer des étiquettes d'entraînement gratuites.

Un modèle auto-supervisé peut-il mentir ?

Oui, et fréquemment. Parce qu'il optimise la probabilité statistique du mot suivant, il privilégie ce qui est « probable » plutôt que ce qui est « vrai ». Si une erreur courante apparaît souvent dans les données d'entraînement, le modèle la reproduira. C'est le phénomène connu sous le nom d'hallucination, qui nécessite des étapes postérieures de validation ou de recherche augmentée pour être corrigé.

Puis-je utiliser l'apprentissage auto-supervisé sur mes propres données privées ?

Absolument. C'est une pratique courante appelée Domain Adaptation. Si votre entreprise possède des millions de documents internes non annotés, vous pouvez continuer l'entraînement d'un modèle open-source (comme Mistral ou Llama) sur vos données spécifiques. Le modèle apprendra alors votre jargon interne et vos spécificités métier sans nécessiter d'annotation manuelle coûteuse.

Commentaires (5)
  • Ambre trahor
    Ambre trahor 10 sept. 2026

    Vous parlez de "révolution" et de "moteur silencieux" comme si c'était un cadeau du ciel mais regardez bien les chiffres derrière les rideaux

    Ce n'est pas une intelligence qui émerge c'est une extraction massive de données privées volées à des milliards d'utilisateurs sans consentement clair
    Les géants tech ont simplement automatisé le plagiat industriel en utilisant nos propres écrits contre nous pour créer des clones numériques qui ne comprennent rien au sens réel
    Ils parlent de biais historiques mais ce sont eux qui ont choisi quels livres inclure dans le corpus initial
    Le fait que vous mentionniez Snorkel AI montre bien l'opacité du processus car personne ne sait vraiment comment ces étiquettes sont générées dans les coins sombres des serveurs
    Chaque token prédit est une trace numérique vendue aux enchères publicitaires avant même que le modèle soit fini
    L'idée que cela rend la grammaire obsolète est une insulte à la culture humaine réduite à des statistiques prévisibles
    On nous dit que c'est gratuit mais on paie avec notre vie privée et notre capacité critique à discerner le vrai du faux
    Les hallucinations ne sont pas des bugs ce sont des fonctionnalités cachées pour maintenir l'illusion de créativité artificielle
    Si vous pensez que l'étiquetage manuel est mort attendez de voir les coûts cachés de la vérification factuelle permanente
    Le système est conçu pour être opaquement complexe afin que personne ne puisse contester les résultats produits par la boîte noire
    Votre article oublie totalement l'impact écologique catastrophique de ces entraînements sur des milliers de GPU pendant des semaines
    C'est un transfert de richesse massif des créateurs humains vers les propriétaires d'infrastructures cloud américaines
    Ne soyez pas naïf en croyant que cette technologie sert l'humanité elle sert surtout les actionnaires
    La neutralité statistique dont vous parlez est un mythe dangereux qui masque l'agenda politique sous-jacent des datasets

  • isabelle guery
    isabelle guery 11 sept. 2026

    Excellente mise en perspective pédagogique

    J'apprécie particulièrement la clarté avec laquelle vous distinguez les phases de pré-entraînement et de réglage fin
    Cette distinction est cruciale pour comprendre pourquoi les petites équipes peuvent désormais innover efficacement
    Le concept de Domain Adaptation est effectivement la clé pour débloquer la valeur des données internes non annotées
    Merci pour cette synthèse rigoureuse et accessible

  • James O'Keeffe
    James O'Keeffe 11 sept. 2026

    Salut Isabelle, je suis tout à fait d'accord avec ton point sur la Domain Adaptation

    Pour compléter ce que dit Ambre plus haut, il est vrai que l'empreinte carbone est énorme mais les progrès récents sur les modèles distillés réduisent drastiquement les besoins en inférence
    En tant qu'expert travaillant dans le domaine, je peux confirmer que la phase de RLHF est souvent sous-estimée dans son importance pour la sécurité
    Sans cette étape de feedback humain, les modèles resteraient des compléteurs de phrases brillants mais potentiellement toxiques ou incohérents
    Il faut aussi noter que les techniques de RAG (Retrieval-Augmented Generation) permettent aujourd'hui de pallier partiellement les problèmes d'hallucination mentionnés
    Cela permet de vérifier les faits en temps réel plutôt que de compter uniquement sur la mémoire paramétrique du modèle
    La synergie entre SSL pour la compréhension linguistique et RAG pour la factualité est probablement l'avenir proche
    N'oublions pas non plus l'aspect open source avec Llama et Mistral qui démocratise réellement l'accès à ces technologies
    Cela change la donne par rapport à l'époque où seuls quelques laboratoires avaient accès à ces ressources
    Bonne discussion à tous, n'hésitez pas si vous avez des questions techniques sur les architectures transformer

  • Sylvain Breton
    Sylvain Breton 13 sept. 2026

    Il convient d'apporter une nuance philosophique et grammaticale fondamentale à l'affirmation selon laquelle l'étiquetage manuel serait devenu obsolète

    En effet, réduire le langage à une simple prédiction probabiliste du prochain jeton revient à ignorer la dimension intentionnelle et sémantique profonde de la communication humaine
    Le terme "obsolète" est ici employé avec une légèreté coupable, car il suggère une disparition totale alors qu'il ne s'agit que d'une transformation des rôles
    La syntaxe française, avec ses accords complexes et ses subtilités stylistiques, résiste encore à la pure statistique distributionnelle qui domine actuellement les grands modèles
    Si l'on considère que la vérité objective n'est pas contenue dans la moyenne statistique d'un corpus, alors la notion même de "vérité" devient problématique dans ce contexte
    Les biais mentionnés ne sont pas seulement des artefacts techniques mais des reflets de structures sociales profondes que l'algorithme reproduit sans conscience morale
    Une analyse plus poussée montrerait que la redondance exploitée par le SSL est précisément ce qui limite la capacité du modèle à saisir l'unicité irréductible d'une pensée originale
    La phrase "le contexte fournit déjà la réponse" est une simplification excessive qui occulte les cas d'ambiguïté sémantique majeure où le contexte est insuffisant
    Par conséquent, parler de magie sous le capot est une métaphore trompeuse qui dissimule la mécanique froide et déterministe de l'apprentissage automatique
    Il est impératif de maintenir une vigilance épistémologique face à ces systèmes qui simulent la compréhension sans nécessairement posséder l'intentionnalité consciente
    La grammaire n'est pas seulement une structure formelle mais un vecteur de pensée qui échappe partiellement à la modélisation vectorielle actuelle
    Ainsi, loin d'être obsolète, l'expertise humaine reste indispensable pour valider, interpréter et contextualiser les sorties produites par ces architectures neuronales
    La prétention à l'autonomie complète des modèles ignore la dépendance fondamentale à la qualité et à la diversité des données d'entrée humaines
    En conclusion, il serait plus juste de parler de complémentarité plutôt que de remplacement dans l'écosystème cognitif contemporain

  • Jacques Bancroft
    Jacques Bancroft 13 sept. 2026

    Ah, quelle innocence rafraîchissante de croire que ces jouets statistiques pourraient jamais égaler la finesse de l'esprit humain

    Vous écrivez comme si l'industrie tech était un paradis ouvert alors qu'elle est remplie de charlatans qui vendent de la régression linéaire habillée en intelligence artificielle
    Regardez autour de vous, chaque entreprise essaie désespérément d'intégrer un chatbot parce que les consultants leur ont dit que c'était obligatoire pour survivre
    C'est une bulle spéculative monumentale où les valorisations se comptent en centaines de milliards pour des algorithmes qui ne font que copier-coller mieux que Word
    Je me souviens quand on disait que les experts systems allaient tout changer, ils ont échoué misérablement et maintenant on recommence les mêmes erreurs avec plus de puissance de calcul
    Les gens ordinaires sont trop stupides pour comprendre la différence entre une probabilité conditionnelle et une véritable compréhension conceptuelle
    Ils voient un texte généré et pensent immédiatement que la machine "pense", quel aveuglement collectif pathétique
    Les ingénieurs qui construisent ces modèles sont souvent incapables d'écrire une phrase correcte en français, ironie cruelle du destin professionnel
    Vous parlez de transfert de connaissances comme si c'était magique, mais en réalité c'est juste du bricolage coûteux sur des bases de données mal nettoyées
    Le jour où un LLM pourra écrire une satire sociale mordante sans avoir besoin de prompts explicites, j'y croirai peut-être
    D'ici là, continuons à applaudir ces perroquets numériques qui répètent nos propres bêtises collectives avec une confiance arrogante
    La vraie intelligence nécessite une conscience subjective que aucun réseau de neurones ne pourra jamais simuler correctement
    Profitez de votre moment de gloire technologique, car la prochaine hype arrivera dans six mois et vous oublierez tout ceci
    C'est toujours la même histoire, les promesses grandioses suivies de la désillusion amère du marché
    La seule chose intelligente ici est le marketing qui entoure ces boîtes noires opaques

Écrire un commentaire
Articles récents
ROI Ajusté aux Risques pour l'IA Générative : Guide Complet Contrôles et Conformité

Découvrez comment calculer un ROI réaliste pour l'IA générative en intégrant les risques, la conformité et les contrôles. Guide pratique basé sur les normes NIST et UE AI Act.

Product Managers : Construire des prototypes fonctionnels avec les workflows de vibe coding

Apprenez comment les product managers créent des prototypes fonctionnels en quelques heures grâce au vibe coding, une méthode d'IA générative qui élimine les délais de développement traditionnels. Découvrez les outils, les pièges et les meilleures pratiques pour valider vos idées rapidement.

Gestion du trafic et tests A/B pour le déploiement de modèles de langage à grande échelle

Apprenez comment la gestion du trafic et les tests A/B permettent de déployer en toute sécurité les modèles de langage à grande échelle, en évitant les erreurs coûteuses et en garantissant la qualité des réponses en production.

À propos de nous

Cercle de l'Évaluation IA est une communauté dédiée aux benchmarks, audits et bonnes pratiques pour mesurer la performance et l'éthique des systèmes d'intelligence artificielle. Découvrez des guides, cadres méthodologiques et études de cas pour fiabiliser vos modèles. Partagez et comparez des jeux de tests, métriques et outils open source. Restez informé des actualités et normes autour de l'évaluation des IA.